别拿 UUID v4 当数据库主键,以及 v7 解决了什么
有一类性能问题的表现特别一致:表刚建起来的时候插入很快,数据涨到几千万行以后,同样的 INSERT 开始变慢,磁盘占用比估算的大出一截,而你并没有改过任何代码。
如果这张表的主键是 UUID,而且是随机生成的那种,那大概率就是它。
先说清楚:想用 UUID 主键的理由是成立的
在批评之前得承认,自增整数主键有几个真实的麻烦:
- 必须先落库才知道 ID。 客户端想先在内存里把一整棵对象树拼好再一次性写下去,做不到——父对象的 ID 得等数据库回一趟。
- 跨库合并会撞车。 分片、多主、离线优先的客户端,各自的自增序列迟早重叠。
- ID 会泄露业务量。 订单号从
/orders/1042变成/orders/1109,竞争对手能数出你一周卖了多少单。这叫德国坦克问题,二战时盟军就是靠序列号估算德军坦克产量的。
UUID 一次解决这三件事:128 位,本地就能生成,重复概率低到可以忽略。所以人们选它没有错。错的是选了哪个版本。
v4 的问题不是”太大”,是”没有顺序”
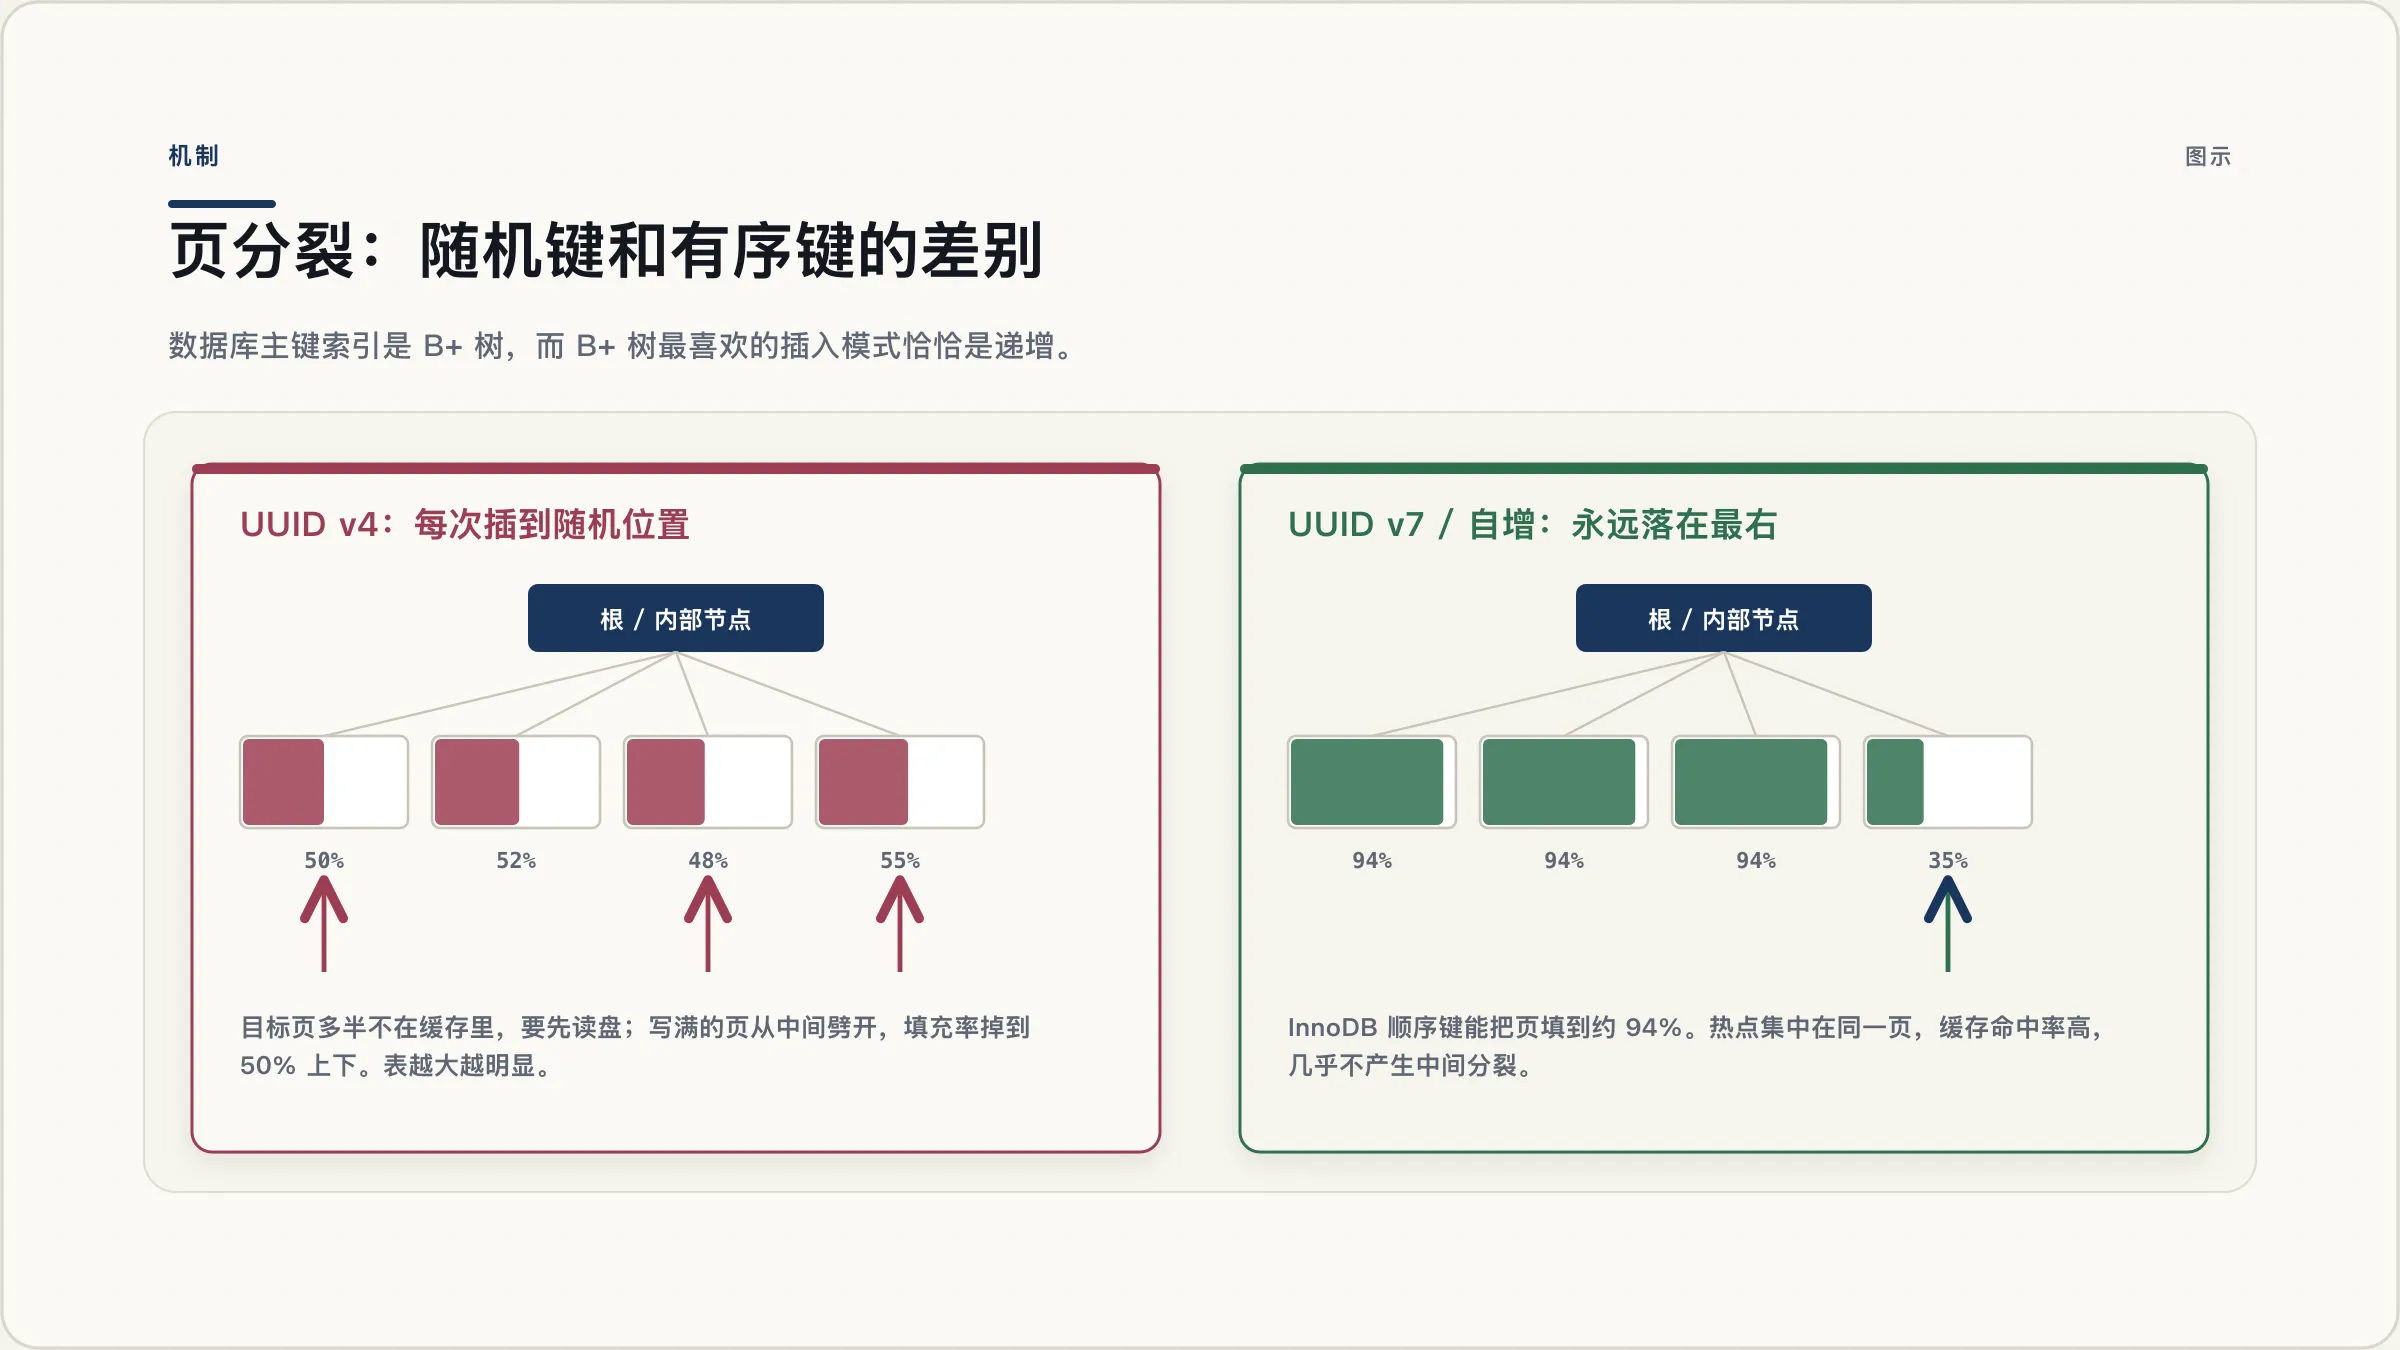
uuid4() 生成的 128 位里有 122 位是纯随机的。这意味着连续生成的两个 ID,在排序上毫无关系——一个可能排在最前面,下一个排在最后面。
而数据库的主键索引是 B+ 树,B+ 树最喜欢的插入模式恰恰是递增。
用自增整数时,新行永远落在最右边那个叶子页上。那一页大概率还在内存里,写满了就新开一页,旧页保持接近写满的状态。用 v4 时,每一次插入都落在树里一个随机位置:
- 要读盘。 目标页很可能不在缓存里,得先从磁盘捞上来才能写。表越大,缓存命中率越低,这就是”数据一多就变慢”的直接来源。
- 页分裂。 往一个已经写满的页中间插一条,这页就得从中间劈成两半。InnoDB 用顺序键能把页填到约 94%,而随机键可能低到 50%——同样的数据,占用接近两倍的空间,缓存里也只能装下一半的有效行。
- 缓存被索引吃光。 因为没有局部性,为了支撑写入,主键索引会占掉大量缓冲池,把本该留给热数据的内存挤出去。
顺带说存储:UUID 用 CHAR(36) 存是九倍于 32 位整数的体积,换成 BINARY(16) 也还有四倍。这条经常被当成主要罪状,其实它只是加重了上面三条——行更大 → 一页装的行更少 → 树更高 → 每次查找多几次 I/O。
InnoDB 和 Postgres,伤的不是同一个地方
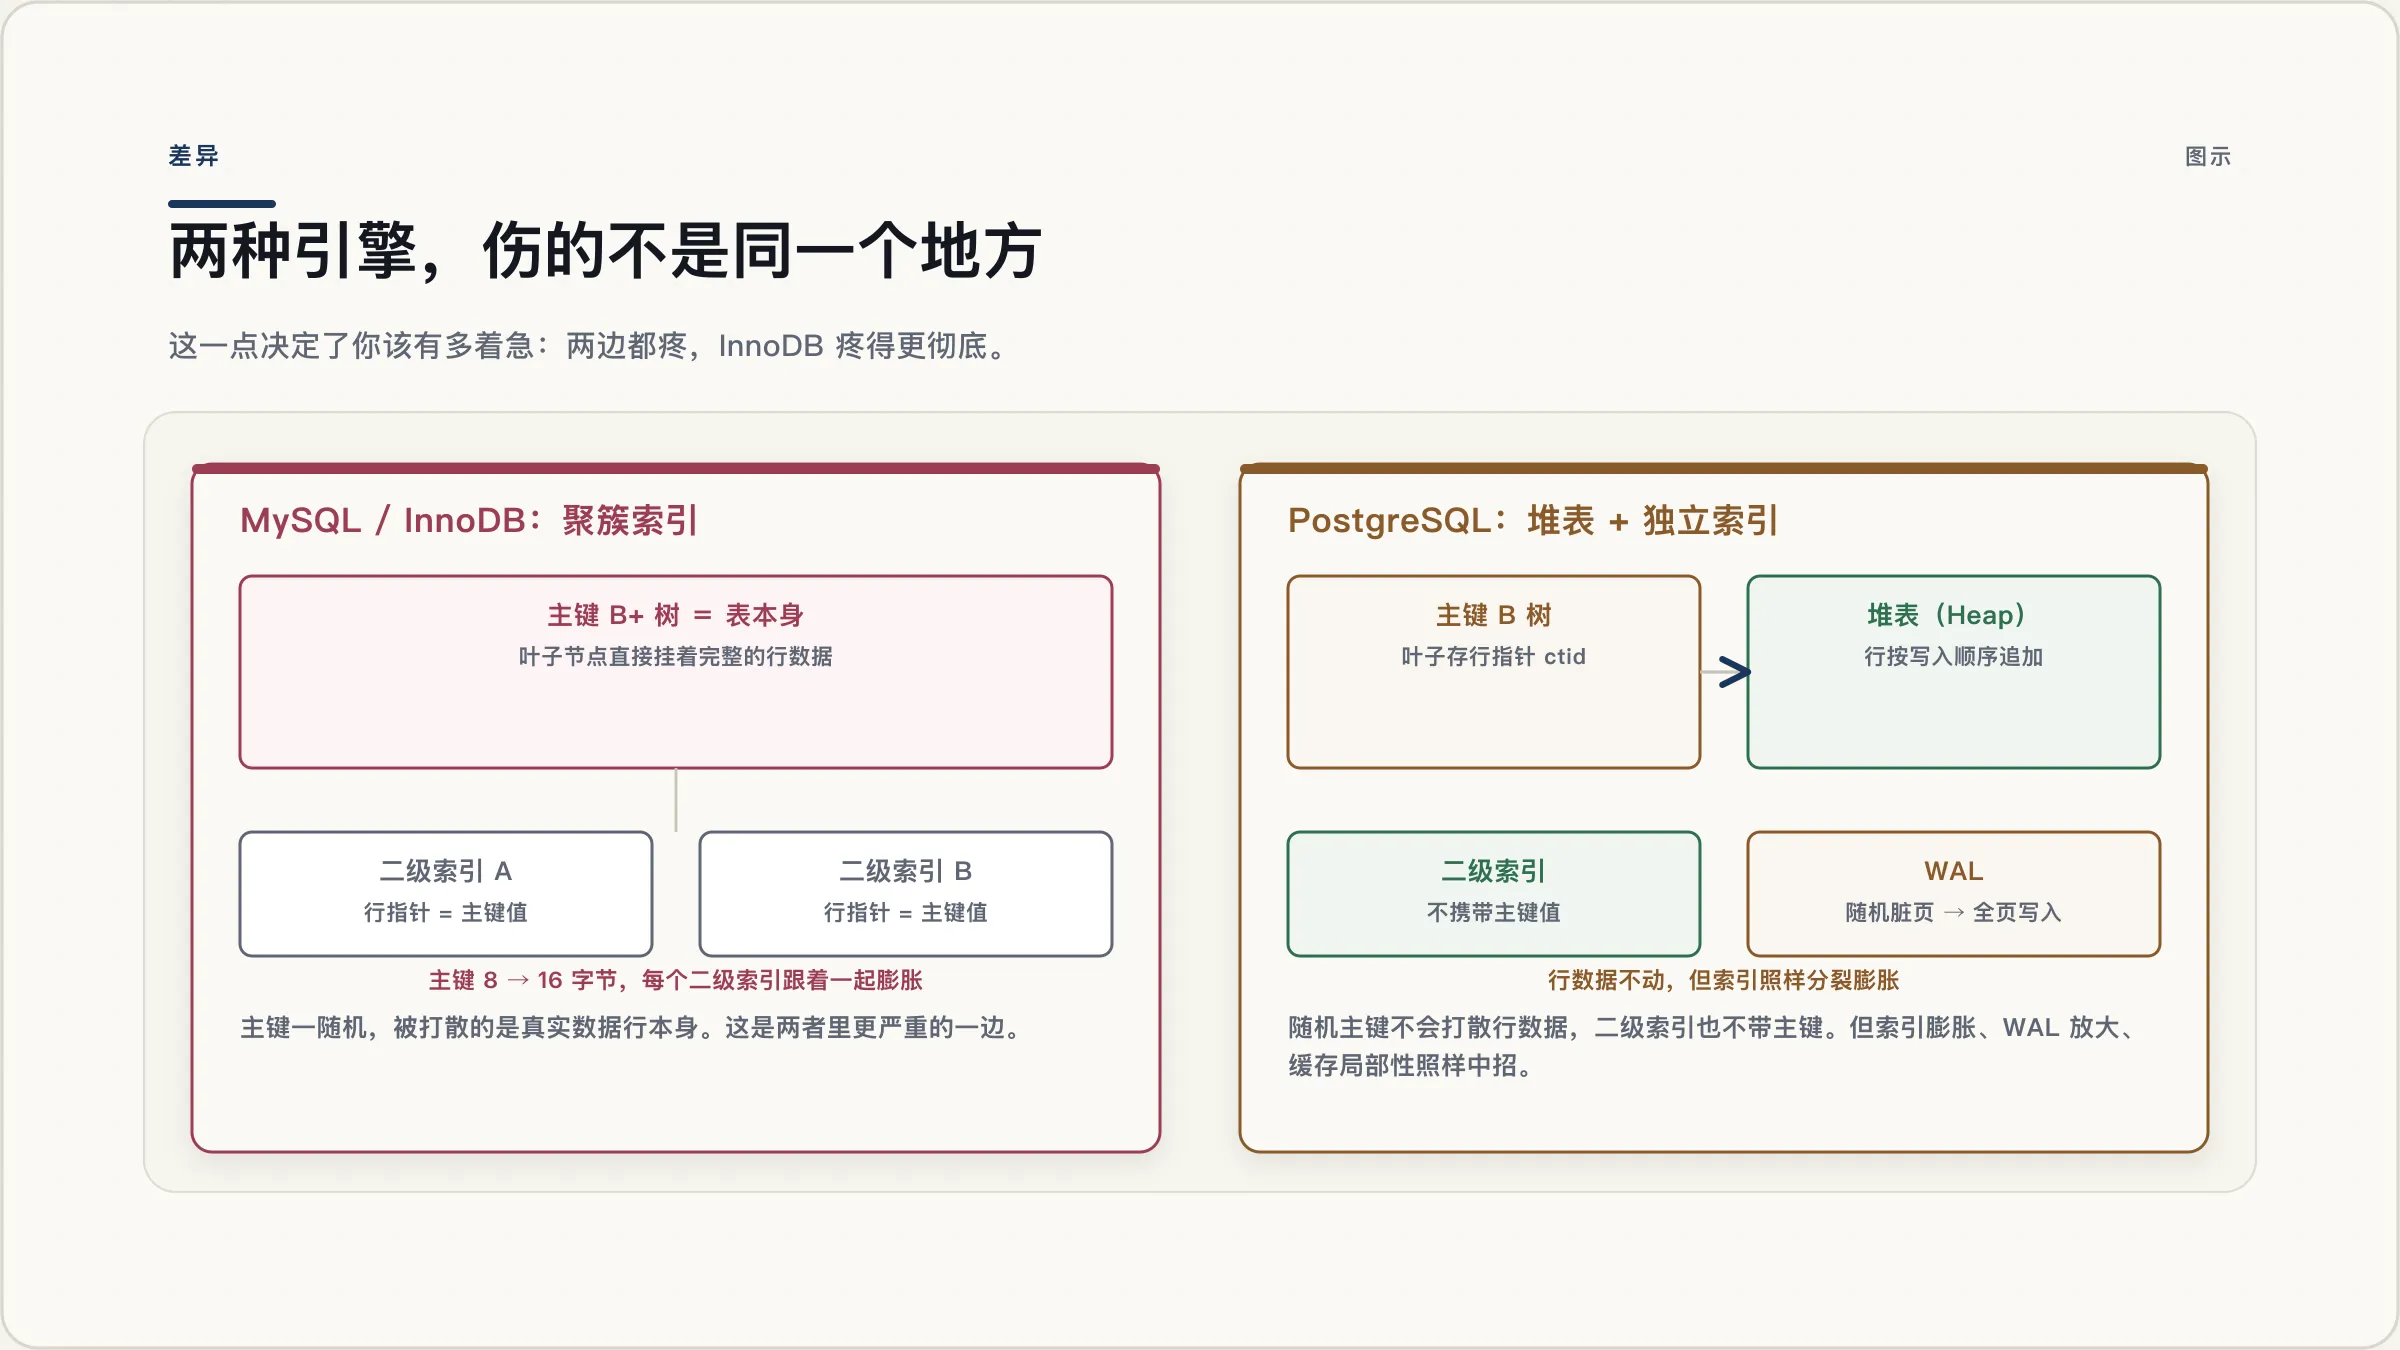
这一点很多文章会含糊过去,但它决定了你该有多着急。
MySQL / InnoDB 是聚簇索引:表本身就是主键 B+ 树。 行数据直接挂在叶子节点上。所以主键一随机,被打散的不只是索引,是你的真实数据行。更糟的是,InnoDB 的每一个二级索引都把主键值当作行指针存着——主键从 8 字节变成 16 字节,你所有的二级索引跟着一起膨胀。
Postgres 是堆表:表和索引是分开的。 行按写入顺序追加到堆文件里,主键只是一棵独立的 B 树,叶子存的是行指针(ctid)。所以在 Postgres 上,随机主键不会打散你的行数据,二级索引也不携带主键值。
但 Postgres 并不豁免。受伤的换成了:主键索引本身照样页分裂和膨胀;随机写入让索引页反复被弄脏,触发大量 WAL 全页写入(full-page write);以及同样的缓存局部性问题。
一句话概括:两边都疼,InnoDB 疼得更彻底。
UUID v7:把前 48 位让给时间
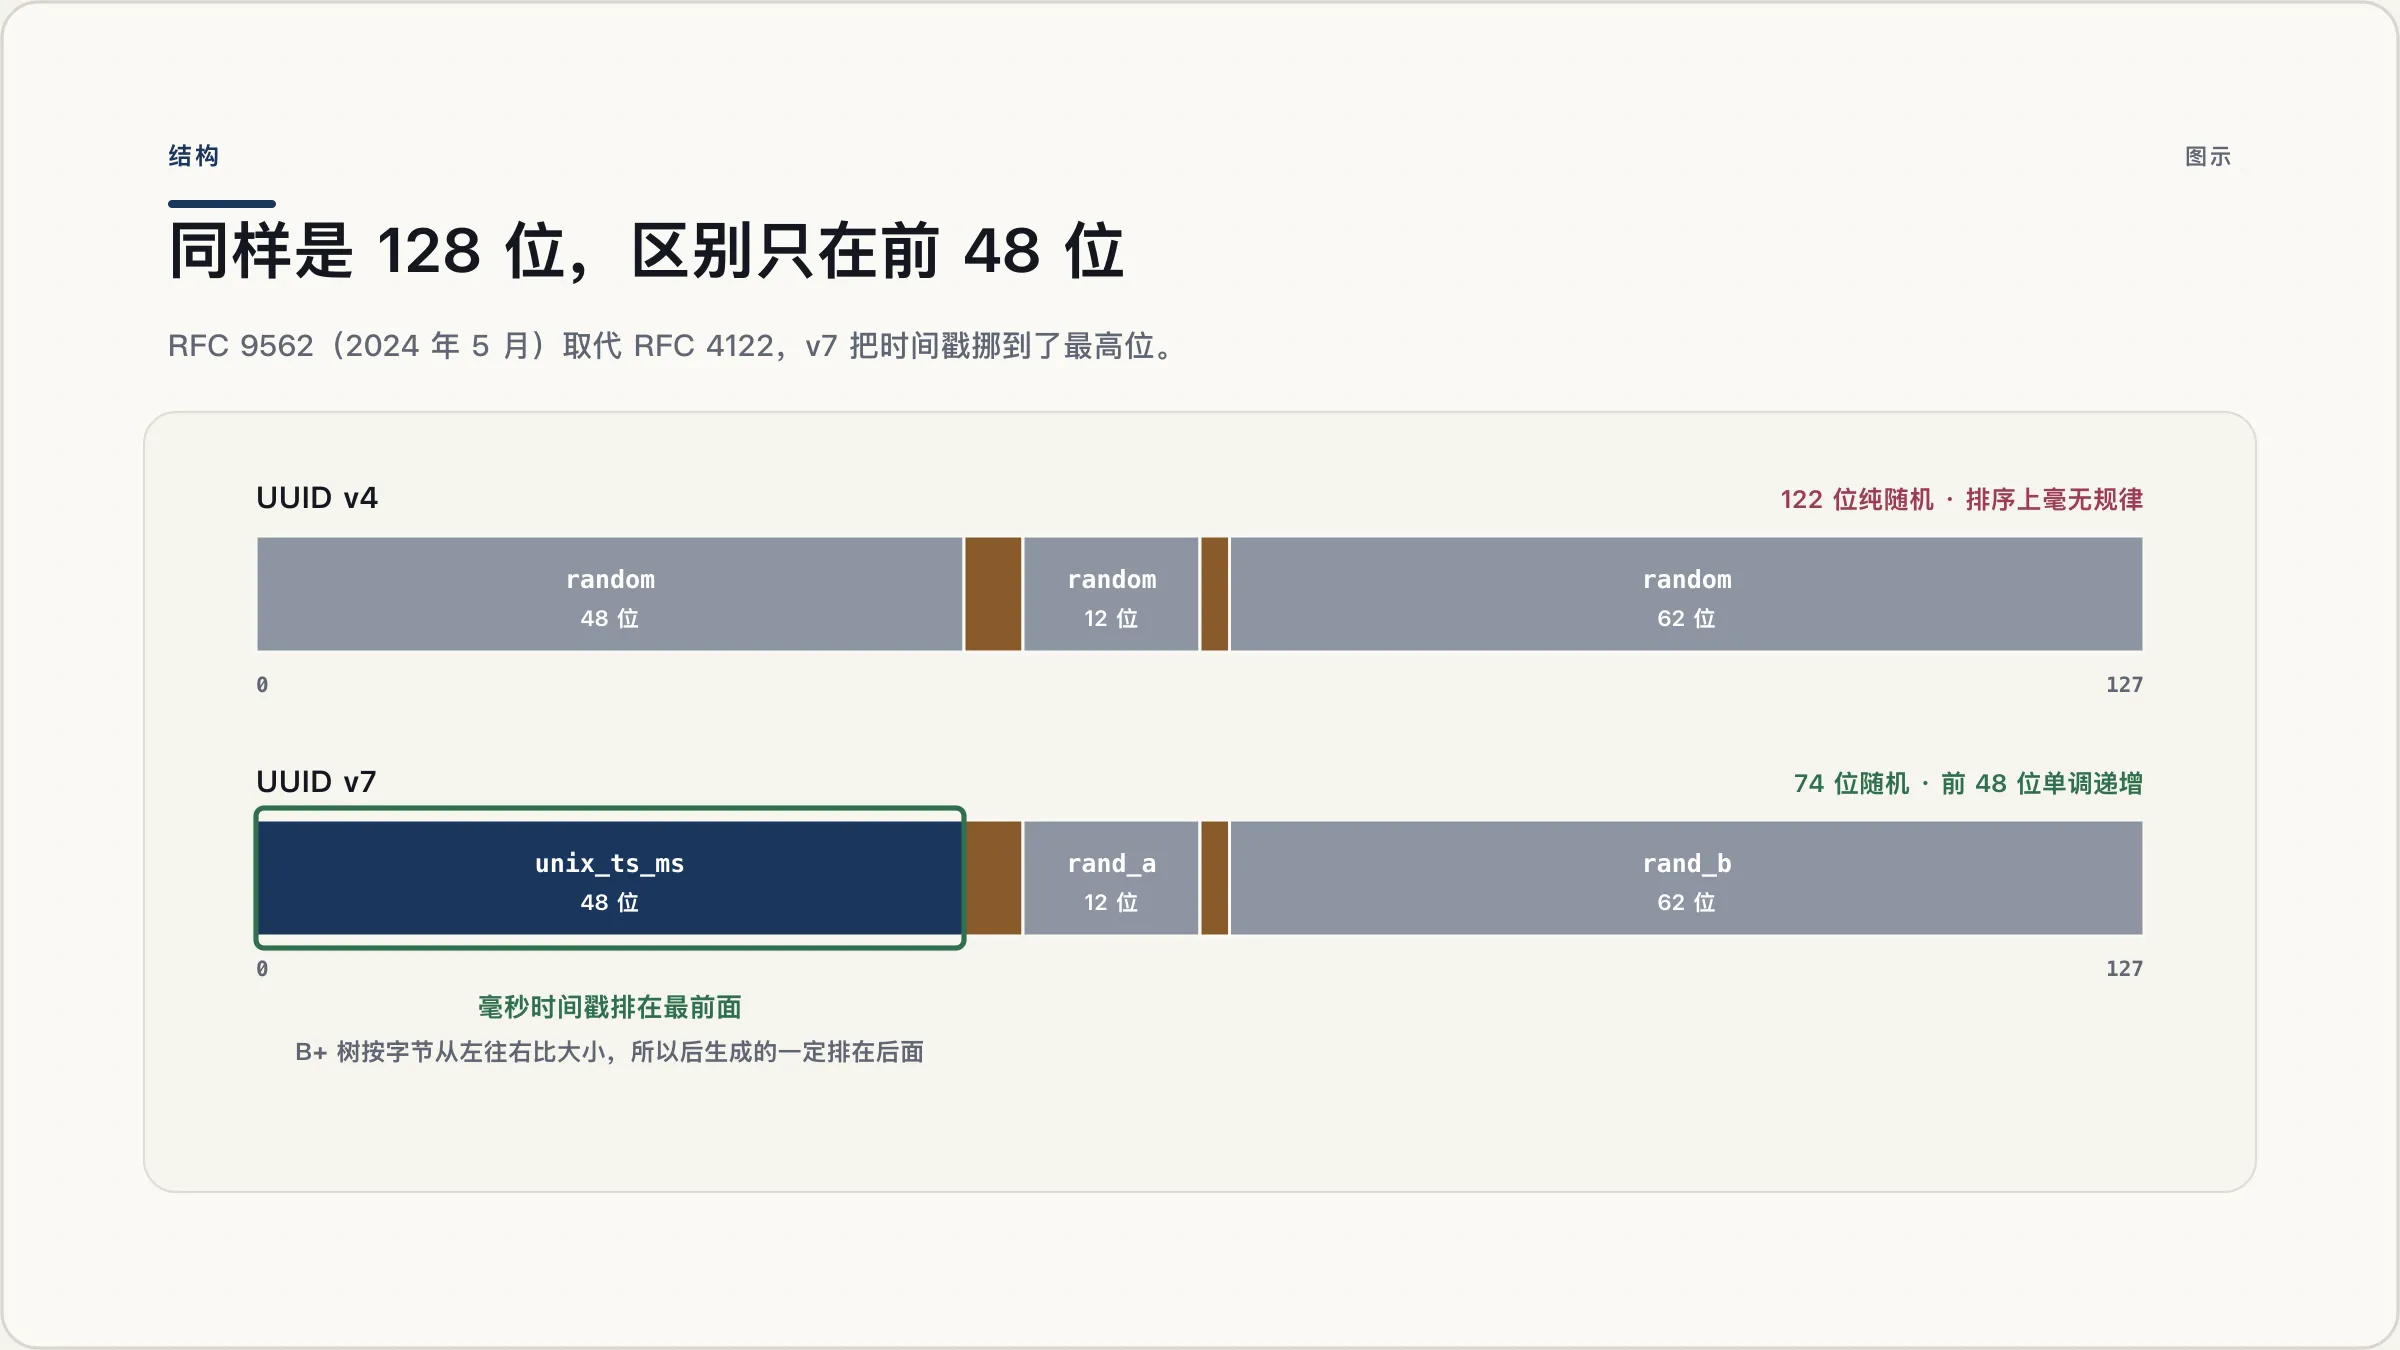
2024 年 5 月,RFC 9562 正式取代了用了二十年的 RFC 4122,并且定义了 v7。它的思路简单到有点朴素——把时间戳放到最前面。
128 位是这么切的:
| 位置 | 宽度 | 内容 |
|---|---|---|
| 0–47 | 48 位 | unix_ts_ms,Unix 毫秒时间戳 |
| 48–51 | 4 位 | 版本号,固定 0111 |
| 52–63 | 12 位 | rand_a,随机数,或用作同毫秒内的单调计数器 |
| 64–65 | 2 位 | 变体位,固定 10 |
| 66–127 | 62 位 | rand_b,随机数 |
关键在于 B+ 树是按字节从左往右比大小的。前 48 位是毫秒时间戳,意味着后生成的 ID 一定排在先生成的后面。插入重新回到”永远落在最右边”的模式,前面说的读盘、页分裂、缓存挤占就全部缓解了。
同时它没有丢掉 UUID 的好处:剩下 74 位随机(12 + 62),本地生成、不会撞车、不能靠加一来枚举,三条都还在。
至于快多少,各家基准测试差别很大,取决于表大小、缓存比例和硬件——但方向高度一致:**v7 大致落在自增整数和 v4 之间,明显好过 v4,仍略逊于 bigint。**别信任何一个精确到百分比的说法,包括我这篇;要数字就在你自己的数据量上跑。
具体怎么用
PostgreSQL 18(2025 年 9 月发布)内置了:
CREATE TABLE orders (
  id uuid PRIMARY KEY DEFAULT uuidv7(),
  created_at timestamptz NOT NULL DEFAULT now()
);

SELECT uuid_extract_timestamp(id), uuid_extract_version(id) FROM orders;
uuidv4() 也加了,作为 gen_random_uuid() 的别名。18 以前的版本用扩展,或者在应用层生成。
MySQL 没有原生 v7。UUID() 给的是 v1。有两条路:
-- 路线 A:应用层生成 v7,按 16 字节存
id BINARY(16) PRIMARY KEY

-- 路线 B:留在 v1,但用 swap flag 把时间字段挪到前面
INSERT INTO t (id) VALUES (UUID_TO_BIN(UUID(), 1));
UUID_TO_BIN(uuid, 1) 的第二个参数会交换 v1 的 time_low 和 time_high,让它变得对聚簇索引友好。但 v1 会嵌入 MAC 地址,v7 没这个包袱——新项目直接走路线 A。
无论哪条路,不要用 CHAR(36) 存 UUID。
v7 的代价,以及不该用它的地方
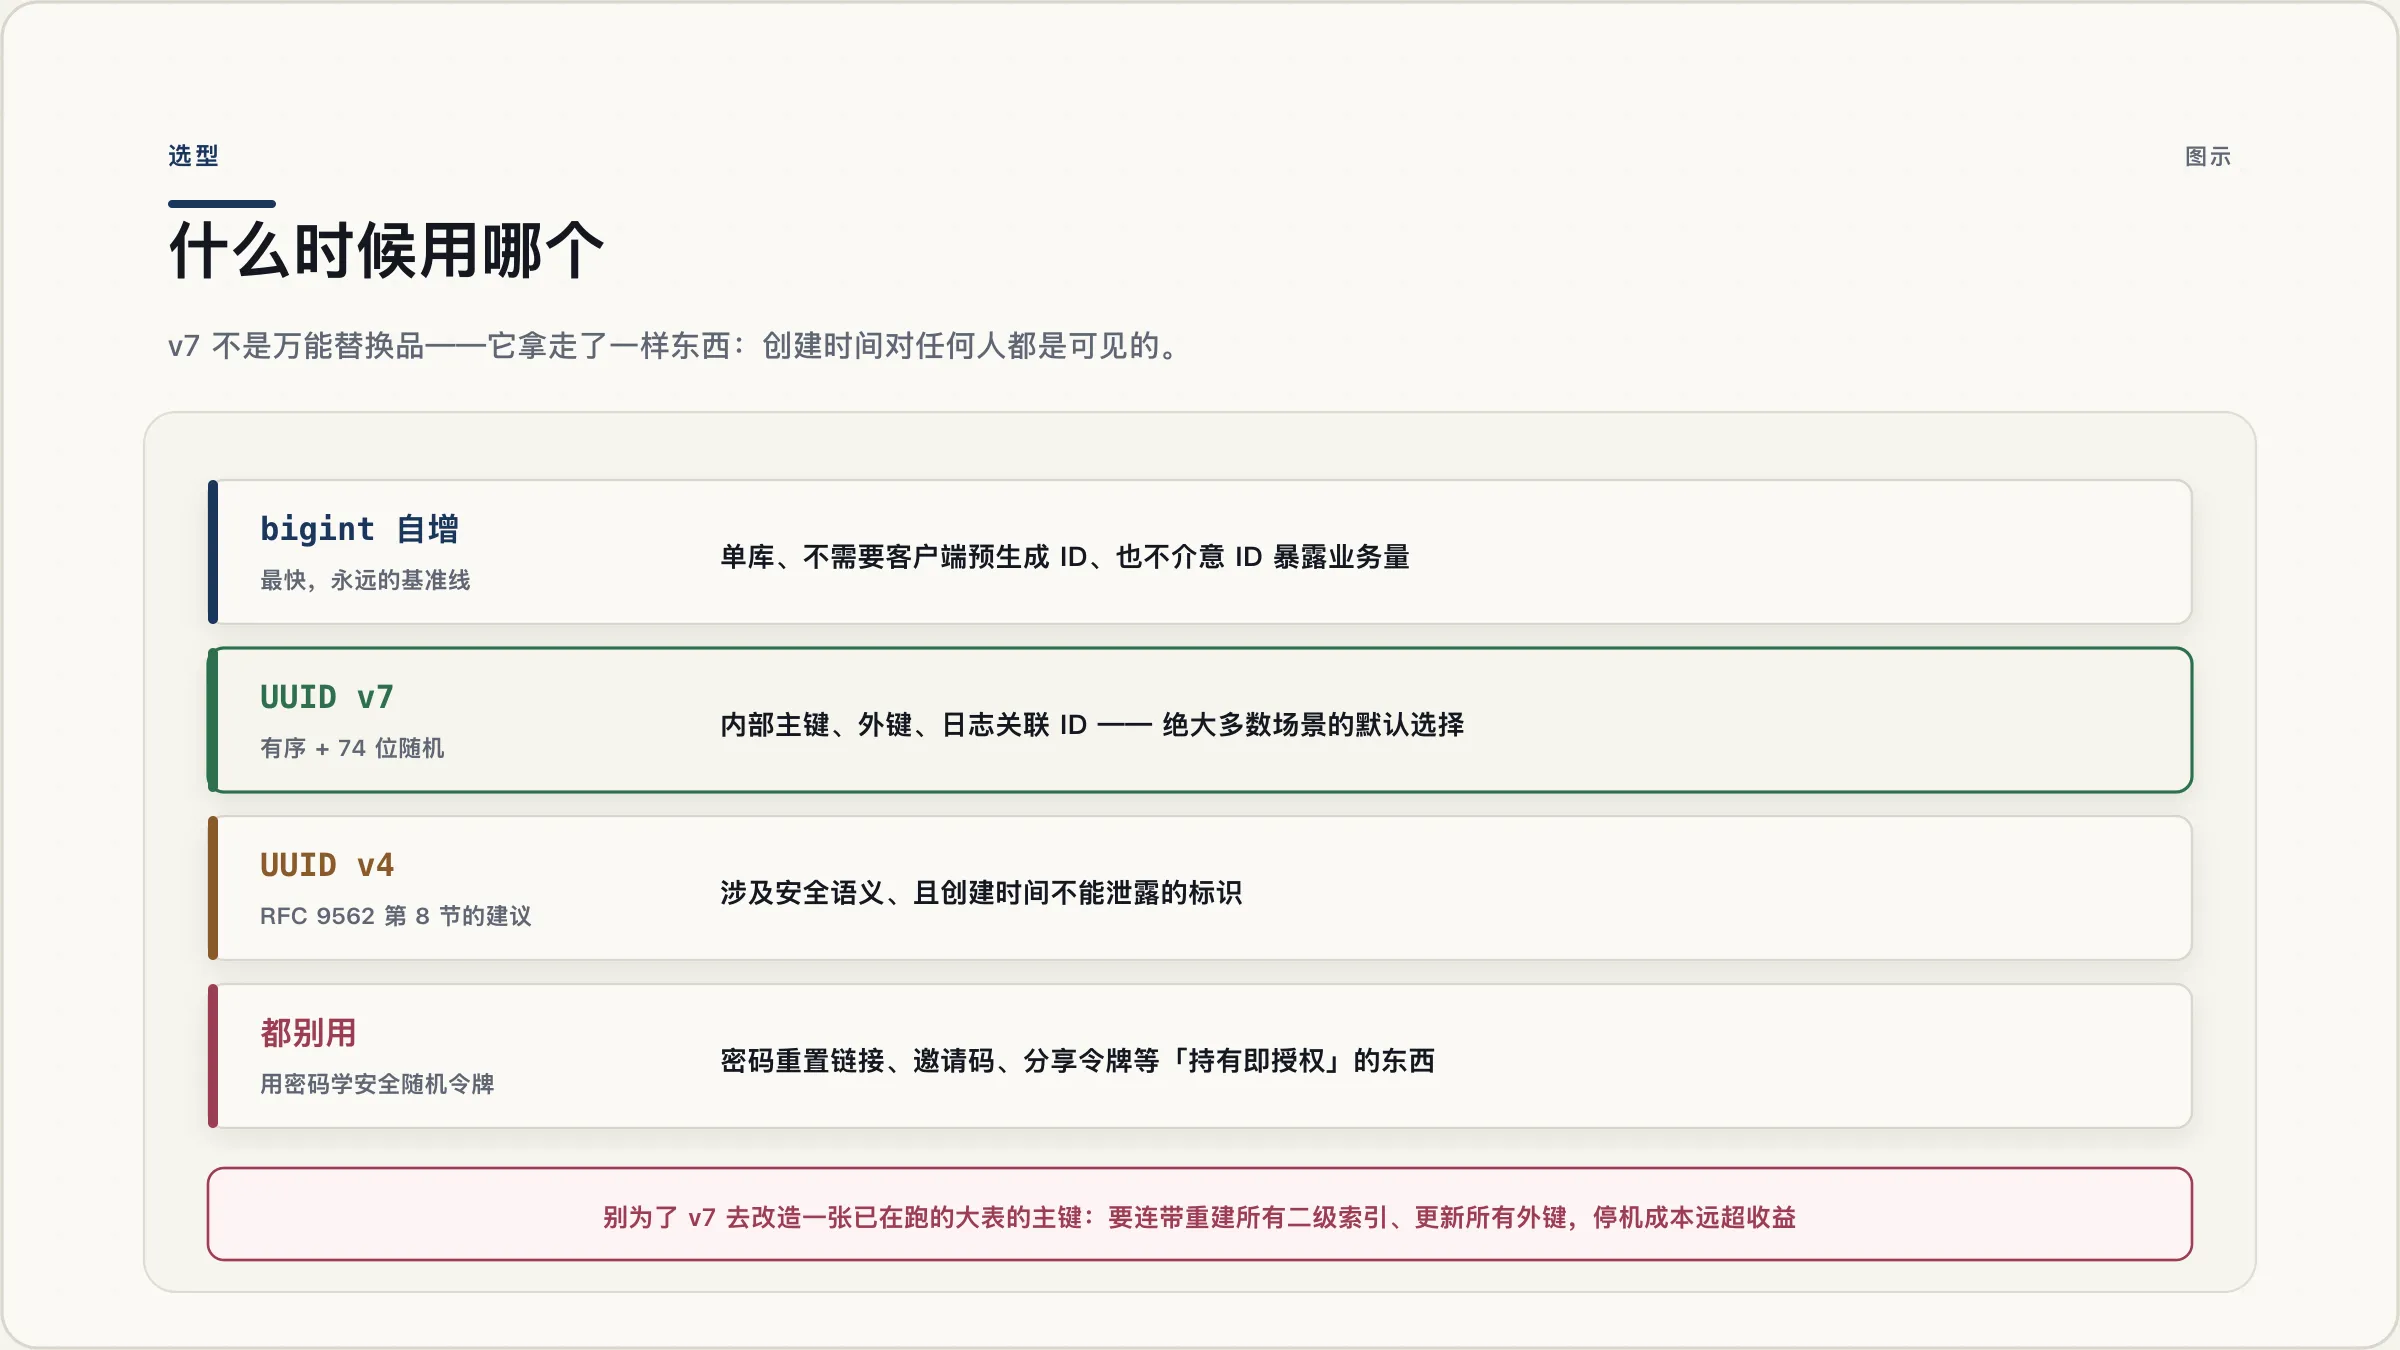
v7 不是免费的,它拿走了一样东西:任何人拿到一个 v7,都能反解出它的创建时间,精确到毫秒。
RFC 9562 第 8 节对此说得很直白:不要假设 UUID 难以猜测,绝不能把 UUID 当作”持有即授权”的安全凭证;如果某个场景涉及安全语义,应该用 v4。
翻译成实践:
- 内部主键、外键、日志关联 ID —— 用 v7,就是它的主场。
- 密码重置链接、邀请码、分享令牌、任何”知道这串字符就能访问”的东西 —— 不要用 UUID,v7 v4 都不要,用密码学安全的随机令牌。
- 暴露在公开 URL 里、而创建时间属于敏感信息的 ID(比如能推断出用户注册顺序、或某条内容的真实发布时间) —— 内部照用 v7,对外单独给一个不含时间的公开标识。
最后一条实践建议:**别为了 v7 去改造一张已经在跑的大表的主键。**重写主键要连带重建所有二级索引、更新所有外键引用,停机成本远超收益。合理的做法是新表一律用 v7,老表等到确实撞上瓶颈、有独立的迁移窗口时再说。
参考:RFC 9562(v7 位布局见 5.7 节,安全考量见第 8 节)、PostgreSQL 18 发布说明、PlanetScale:MySQL 用 UUID 主键的问题。