缓存穿透、击穿、雪崩:三个词很多人背混了
这三个词是中文面试里出现频率最高的 Redis 题,也是被背混得最厉害的。常见的混乱长这样:把击穿说成穿透,或者反过来;三种解法混着背,结果给雪崩开了个布隆过滤器的药方。
根源在于这三个词长得太像,而且都被概括成”请求打到数据库了”。但它们问的是三个不同的失效位置,一旦分开看就很难再混。
两个问题就能分开
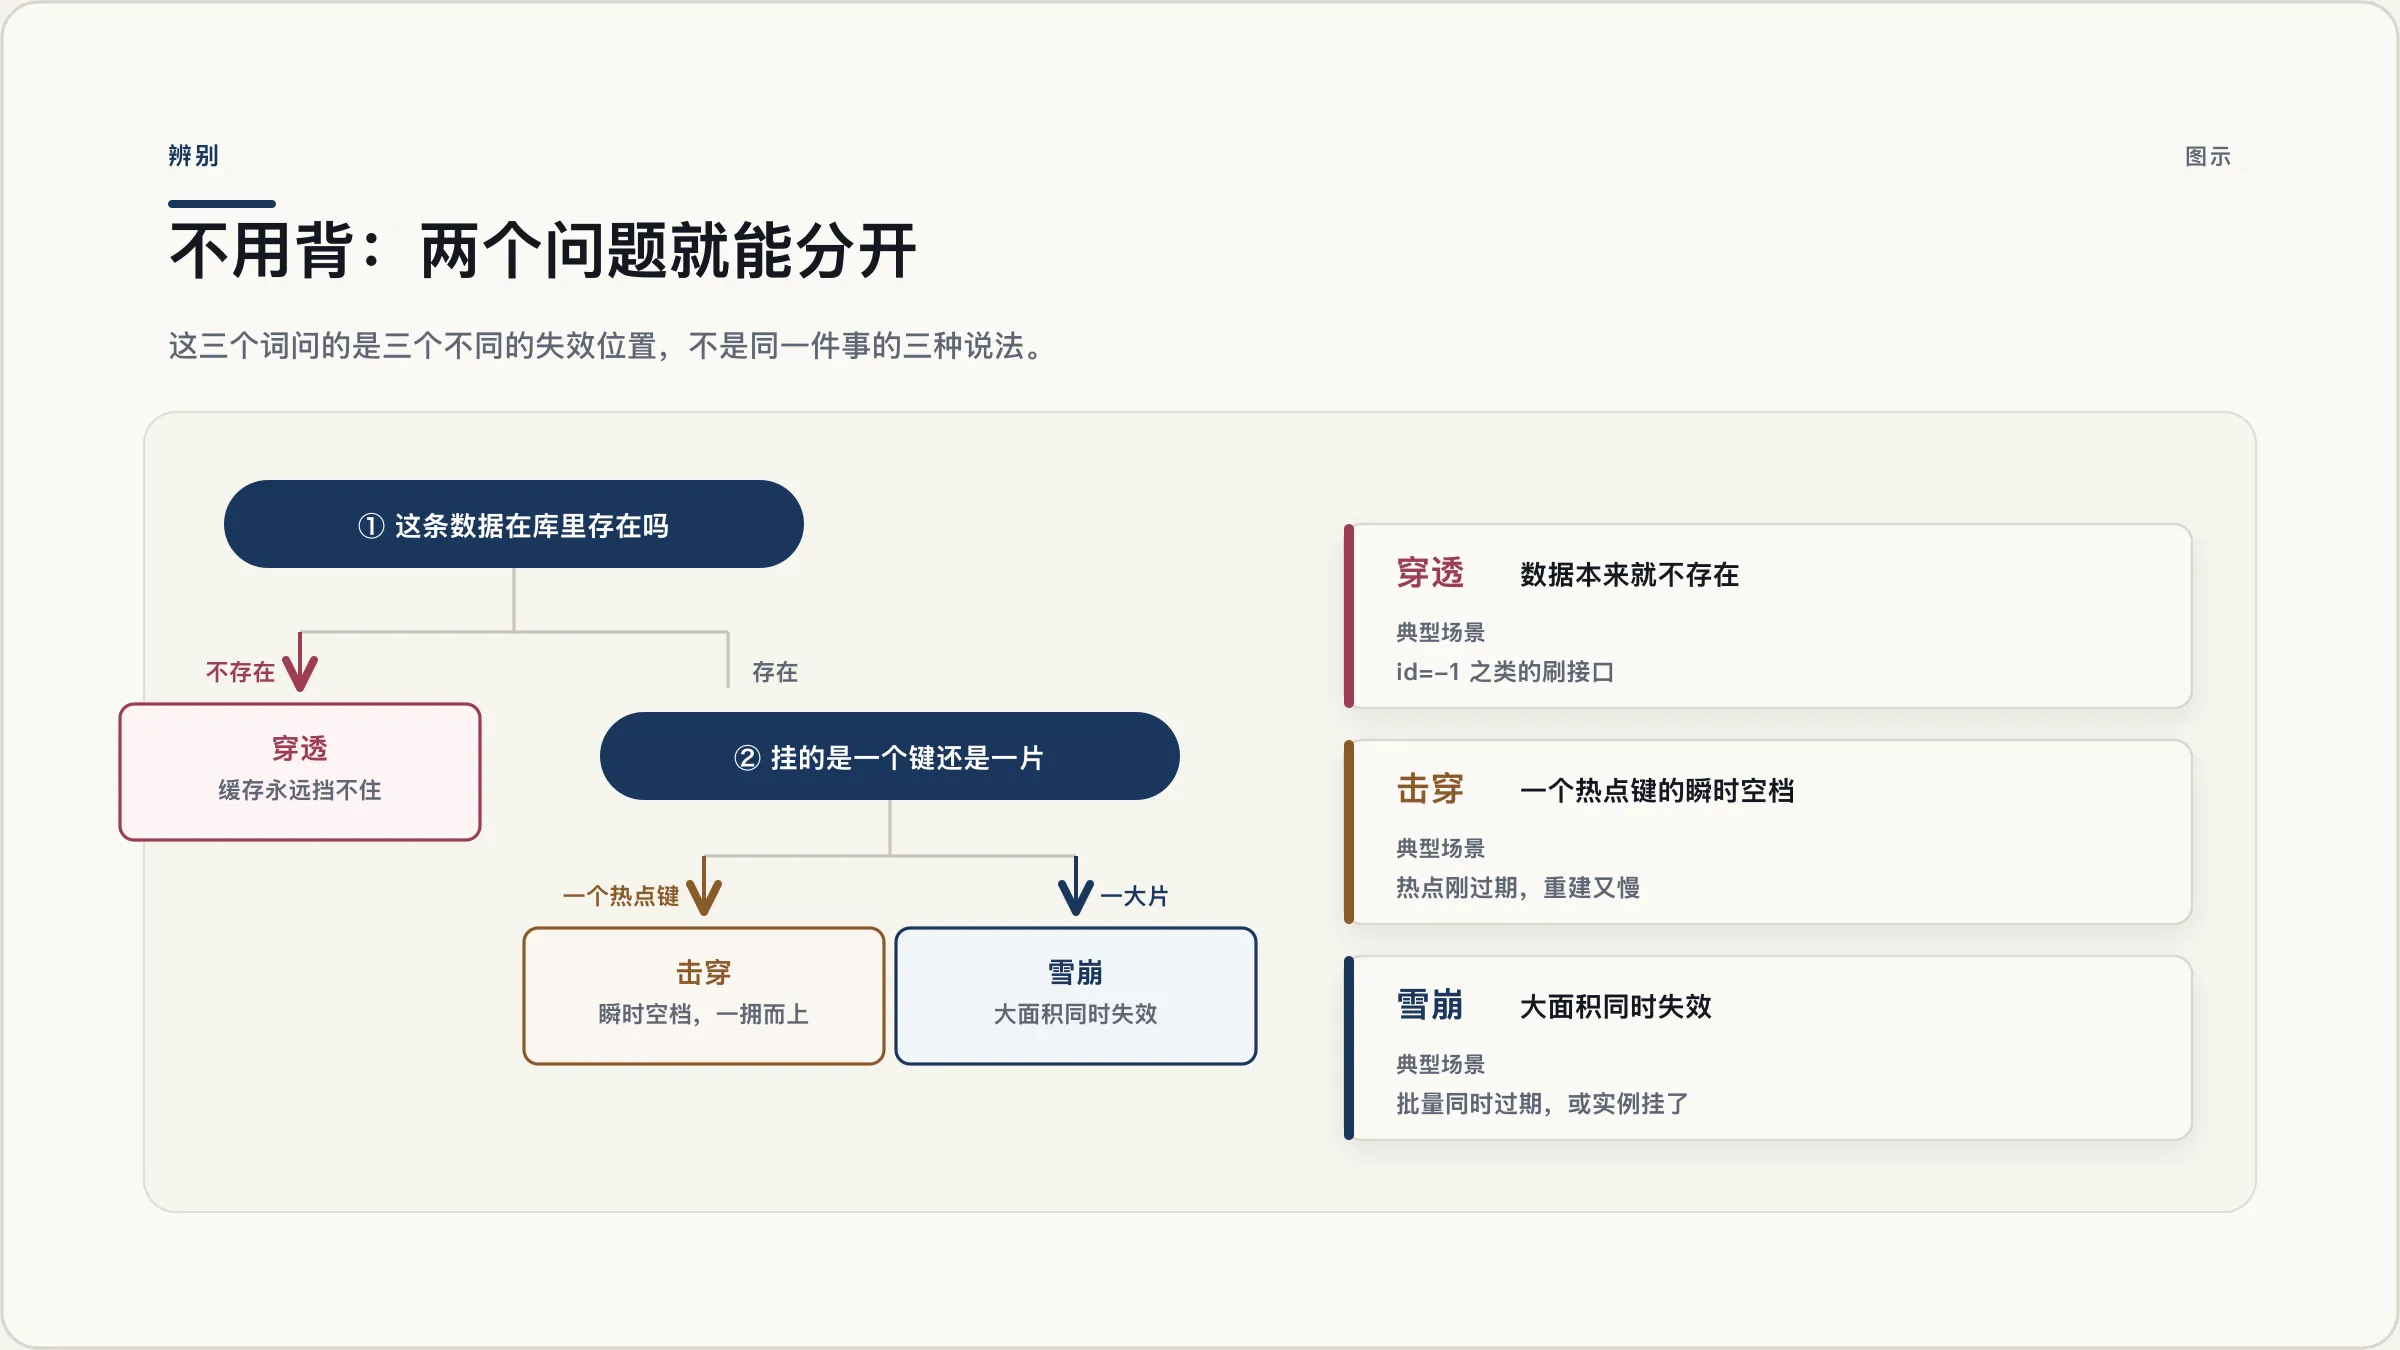
不用背,问两句话:
第一问:这条数据在数据库里存在吗?
不存在 —— 是穿透。缓存里当然没有,数据库里也没有,所以缓存永远挡不住它,每次都会漏到库里。典型场景是有人拿 id=-1 或者随机 UUID 刷你的接口。
存在 —— 继续问第二问。
第二问:这次挂掉的是一个键,还是一大片?
一个 —— 是击穿。某个热点键刚好过期,重建又需要时间,这个空档里所有请求一起涌向数据库。
一大片 —— 是雪崩。大批键在同一时刻集体过期,或者 Redis 实例直接挂了,一瞬间几乎所有请求都落到库上。
三个词的区别就这么点:穿透是数据本来就不存在,击穿是一个热点键的瞬时空档,雪崩是大面积同时失效。
穿透:布隆过滤器的误判方向恰好是对的
穿透的麻烦在于,常规缓存逻辑对它完全无效——查缓存没有,查数据库也没有,于是什么都没得存,下一个请求原样再来一遍。
最简单的办法是缓存空值:数据库查不到,就往缓存里写一个空标记,给个较短的 TTL(比如 30 秒到几分钟)。要点是 TTL 必须短,否则这条数据后来真的被创建出来,你会在很长一段时间里对外宣称它不存在。
更彻底的是布隆过滤器:把所有存在的 key 预先灌进去,请求先过一遍过滤器,判定不存在就直接拒绝,根本不碰缓存和数据库。
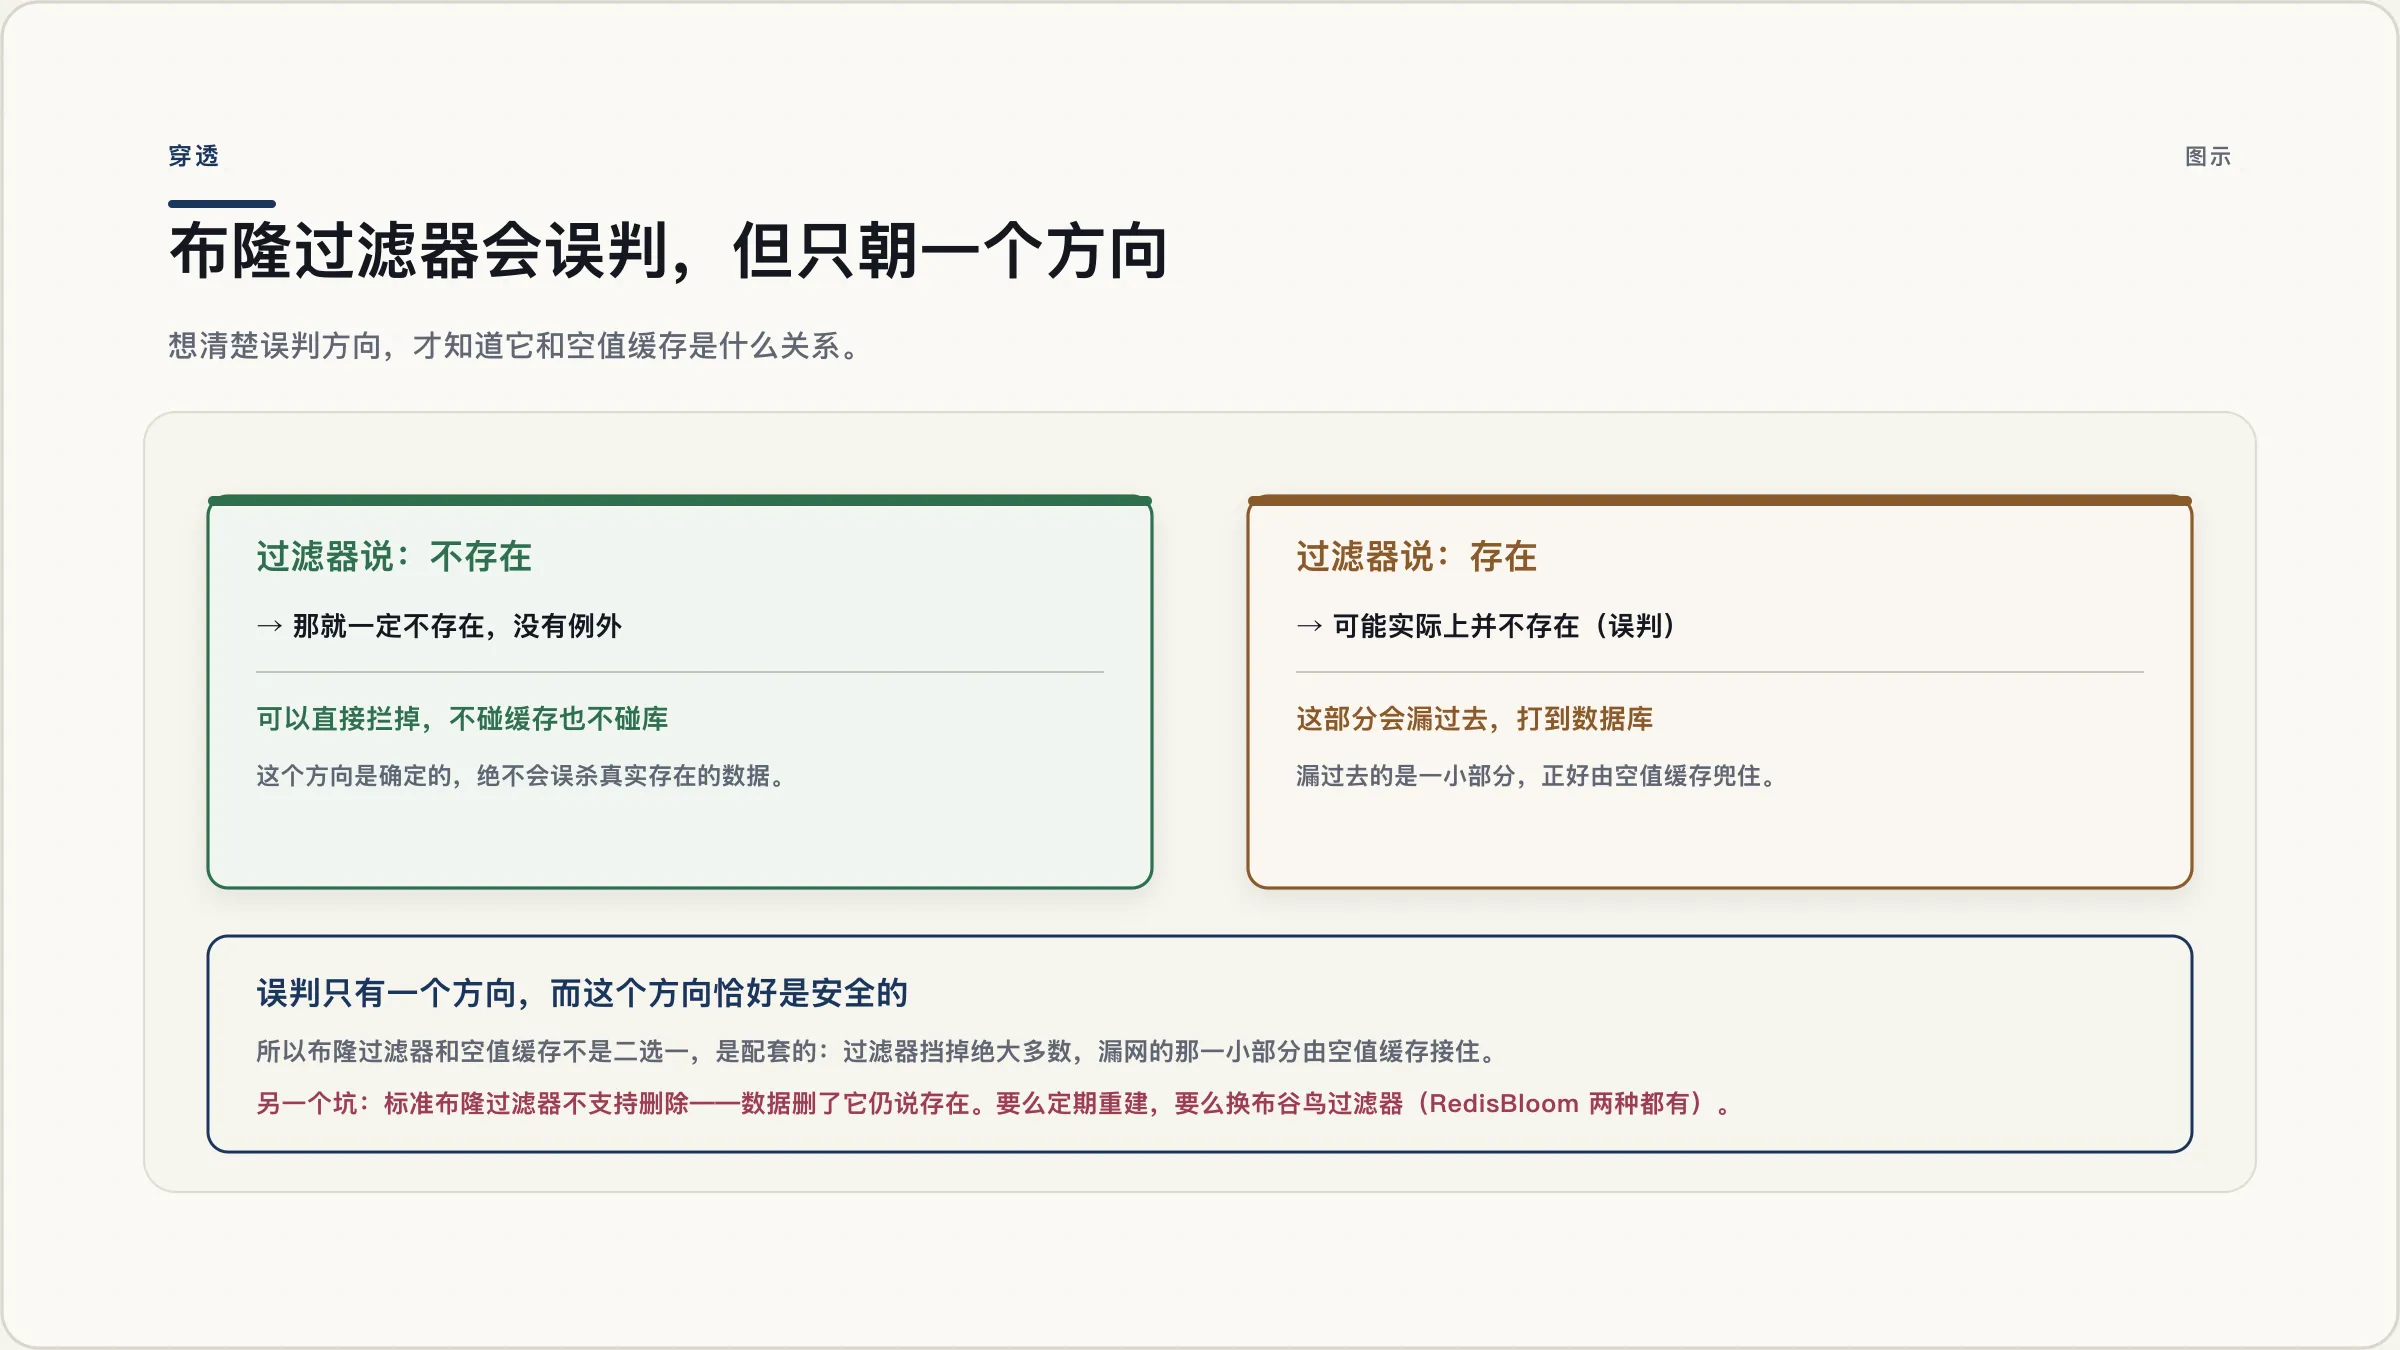
这里有个值得想清楚的点——布隆过滤器是会误判的,但它的误判只有一个方向:
- 它说不存在,那就一定不存在。可以放心直接拦掉。
- 它说存在,可能实际上不存在。这个请求会漏过去,打到数据库。
对拦截穿透来说,这个方向恰好是安全的:它绝不会把真实存在的数据误杀,只会放过一小部分本该拦下的。漏过去的那一小部分,正好由前面的空值缓存兜住。两个方案不是二选一,是配套的。
另外一个常被忽略的坑:标准布隆过滤器不支持删除。数据从库里删掉了,过滤器仍然认为它存在。要么定期重建整个过滤器,要么换成支持删除的布谷鸟过滤器(Cuckoo Filter)——Redis 的 RedisBloom 模块两种都提供。
击穿:它在英文里有个正式名字,还有篇论文
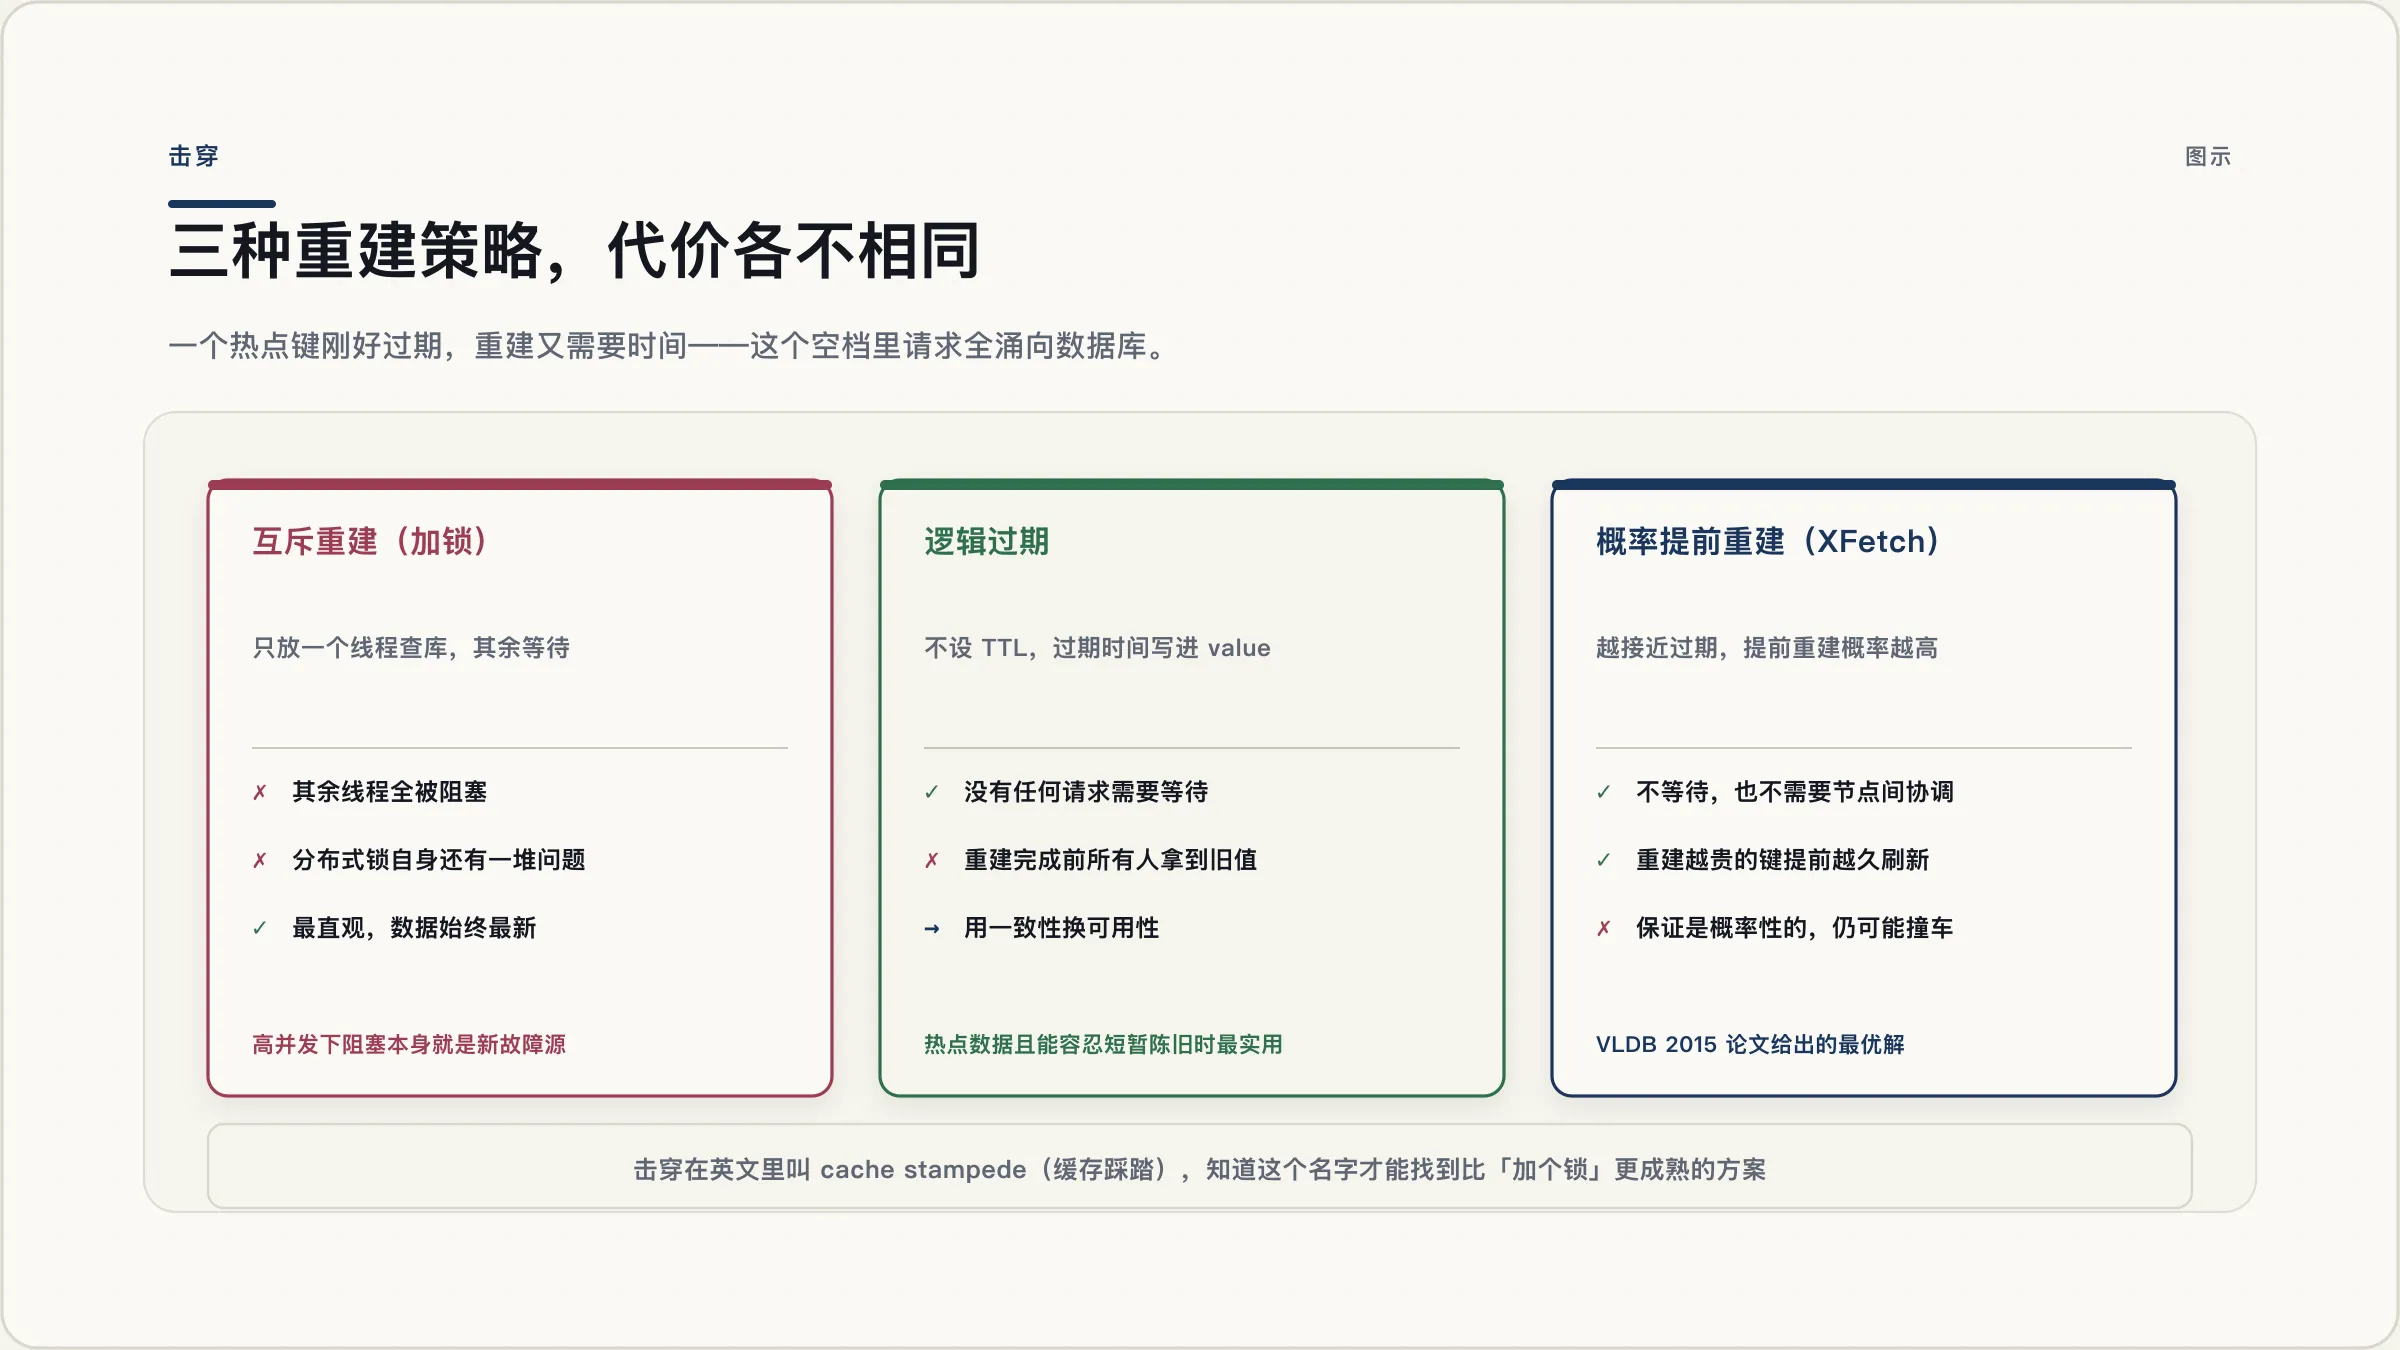
击穿在英文文献里叫 cache stampede(缓存踩踏),也叫 thundering herd。知道这个名字很有用,因为顺着它能找到比”加个锁”更成熟的方案。
常见解法有三条路,代价各不相同:
一、互斥重建(加锁) 只放一个线程去查库重建,其余的等待或返回旧值。最直观,但代价是其余线程全被阻塞——在秒杀这种量级下,阻塞本身就是新的故障源。而且这个锁如果是分布式锁,你又得处理锁本身的一堆问题。
二、逻辑过期 键本身不设 TTL(物理上永不过期),把过期时间写进 value 里。读到发现逻辑上已过期,就先把旧值返回给用户,同时异步触发重建。好处是没有任何请求需要等待,代价是在重建完成前,所有人拿到的都是旧数据——用一致性换可用性。热点数据、且能容忍短暂陈旧时,这条路最实用。
三、概率提前重建(XFetch) Vattani、Chierichetti 和 Lowenstein 在 VLDB 2015 的论文 Optimal Probabilistic Cache Stampede Prevention 里提出的做法:不等过期,每个请求独立地按概率决定要不要提前重建,越接近过期时间,概率越高。
判定式是这样的:
if (now - delta * beta * log(rand(0,1))) >= expiry:
    重建缓存
delta 是上次重建耗时,beta 是调节激进程度的参数(论文建议取 1)。这个式子有个漂亮的性质:重建越贵的键,会被提前越久开始刷新。
它的好处是没有任何请求需要等待,也不需要节点间协调。代价是保证只是概率性的——并发足够高时,仍然可能有两个节点同时重建。
雪崩:两种成因,其中一种加抖动完全没用
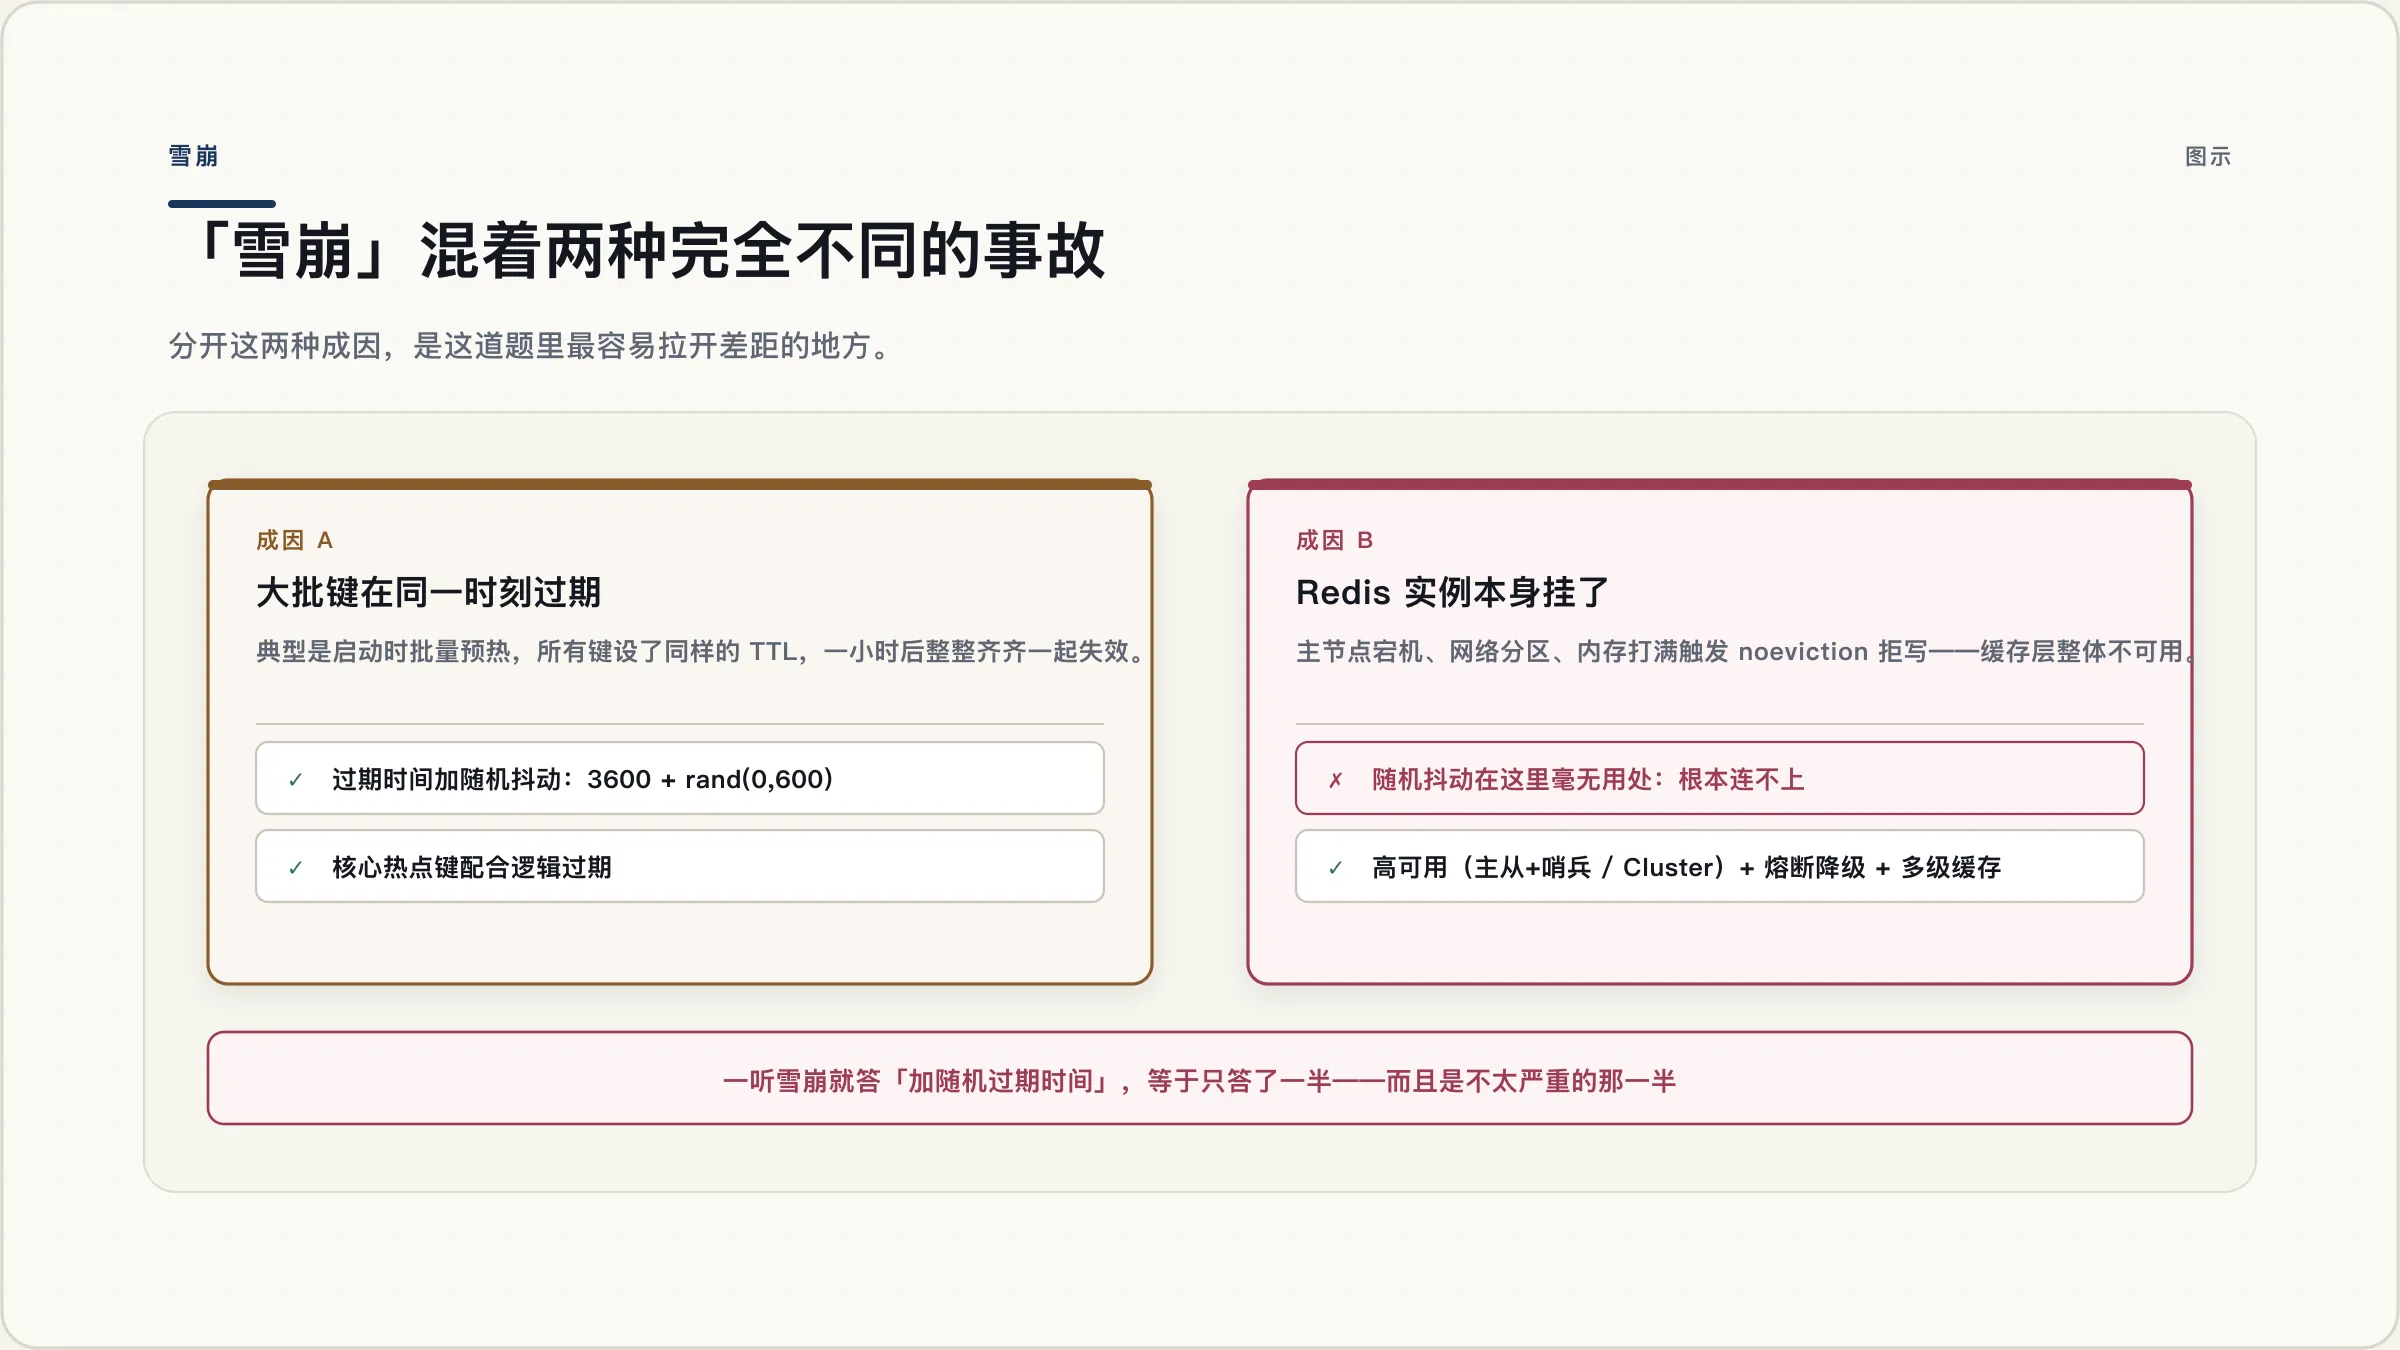
雪崩这一节是错得最多的,因为”雪崩”其实混着两种完全不同的事故:
成因 A:大批键在同一时刻过期。 典型是服务启动时批量预热,给所有键设了同样的 TTL,于是一小时后它们整整齐齐一起失效。
这种的解法很简单:过期时间加随机抖动。别写 EXPIRE key 3600,写 3600 + rand(0, 600),把失效时刻摊开在一个窗口里。核心热点键也可以配合前面说的逻辑过期。
成因 B:Redis 实例本身挂了。
主节点宕机、网络分区、内存打满触发 noeviction 开始拒写——缓存层整体不可用。
对这一种,随机抖动毫无用处。 键还在不在都无所谓了,因为根本连不上。这里要的是完全另一套东西:
- 高可用:主从 + 哨兵,或者 Cluster,让故障能自动转移。
- 熔断和降级:缓存不可用时,别让全部流量直冲数据库。该限流限流,该返回兜底数据返回兜底数据——保住数据库比保住这次请求的正确性重要。
- 多级缓存:应用本地留一层(Caffeine 之类),Redis 挂了还能扛一阵。
把这两种成因分开,是这道题里最容易拉开差距的地方。很多人一听雪崩就答”加随机过期时间”,等于只答了一半,而且是不太严重的那一半。
面试时怎么答
如果只能记一件事,记这个顺序:先定位,再给方案。
| 数据在库里 | 失效范围 | 主要解法 | |
|---|---|---|---|
| 穿透 | 不存在 | —— | 空值缓存 + 布隆/布谷鸟过滤器 |
| 击穿 | 存在 | 单个热点键 | 互斥重建 / 逻辑过期 / 概率提前重建 |
| 雪崩 | 存在 | 大面积 | 过期抖动(批量过期);高可用 + 熔断降级(实例宕机) |
被问到时,不要直接背解法。先说清楚”这三个是三个不同的失效位置”,再按位置给方案——顺带说出雪崩的两种成因和 cache stampede 这个正式名字,基本就够了。
最后提醒一句:真实系统里这三件事不是互斥的,一次故障常常是连着来的。热点键击穿把数据库打慢,数据库慢导致重建更慢,重建慢又让更多请求堆积——最后表现出来的就是雪崩。分类是为了想清楚,不是为了在事故现场做填空题。
参考:Cache stampede(含 XFetch 公式)、Vattani 等,Optimal Probabilistic Cache Stampede Prevention,VLDB 2015。